1판을 읽었던 게 얼마 되지 않은 것 같은데 벌써 3판이 나왔다. 그 사이 우리가 겪은 AI 기술의 발전 속도는 정말 놀라웠다. 하루 하루 새로운 개념과 접근법이 쏟아져 나왔다. 그동안 어떻게 가만히 목소리를 죽이고 있었을까 하는 생각이 들 정도였다. 분류와 회귀 예측이 주류였던 딥러닝 시대를 지나, 어느새 자연스럽게 생성(Generative AI)의 시대로 넘어왔다.
나는 딥러닝이나 AI를 전문적으로 공부하는 연구자가 아니다. 딥러닝이나 LLM의 결과물을 서비스에 활용하여 구현하는 개발자로서, 요즘 LLM 모델 연동 방식을 보면 API 한 줄로 호출하거나 허깅페이스에서 코드 몇 줄 긁어오면 그럴듯한 AI 기능이 뚝딱 구현된다. 그런데 '돌아만 가는 코드'나 단순 API 연동만으로는 한계가 분명하다. 현장에서만 발생하는 문제를 접하다 보면 내부 작동 메커니즘을 모르면 막힐 수밖에 없다. 그렇기에 그냥 왠만한 것은 LLM으로 해결되더라도 머리를 싸매가며 딥러닝 기초를 다시 파고들어 본다. 마침 10월 연휴가 있어서 이번 기회에 다시한번 리마인드하리라 결심했건만, 책을 끝까지 읽기가 쉽지 않다. 그래서 심기일전의 마음으로 지금까지 읽으면서 들었던 생각을 글로 정리하고 나머지 부분을 계속 이어 읽어 나가고자 한다.
밑바닥부터의 이해가 가져다 줄 직관을 위해...
예전에 자료구조나 알고리즘을 손수 입력해 보면서 공부했던 것이 일상의 작업에 당장 100% 활용되지 않는 것처럼 느껴질 때가 있었다. 특히 요즘처럼 AI가 코드를 대신 작성해 짜주는 시대에 예전처럼 손수 딥러닝 프레임워크를 파고드는 것이 무의미할 지도 모른다. 그런데 결국 엔지니어링이란 원하는 목표를 적기에 적정 비용으로 시장에 내놓아야하는 숙명을 타고났는지라, 이 책을 읽는다.
그런데 왜 하필 케라스일까? 사실 이 책의 원제에는 케라스라는 단어는 찾을 수 없다. 다만 케라스의 창시자라 불리는 프랑소와 숄레와 핵심 메인테이너인 매튜 왓슨이 적은 딥러닝 책이다. 창시자가 설명하는 내용은 매력적일 수 밖에 없다. 창시자란 뭔가 새로운 것을 만들어 냈다는 사실보다는 세상을 자신만의 관점으로 풀어내는 틀을 정리해냈단 점이 대단하다고 생각하는데, 그런 점에서 케라스의 창시자가 바라보는 관점은 생각의 갈피를 많이 제공해 준다. 숄레가 썼다고 해서 이 책을 단지 케라스 사용법으로 생각하면 오산이다. 개인적으로 3장이 마음에 들었는데, 선형 분류기를 주요 딥러닝 프레임워크인 텐서플로, 파이토치, JAX, 케라스에서 구현하면서 각 프레임워크의 지향점을 옅볼 수 있다. 그렇다고 케라스에 치우친 설명은 아니다.
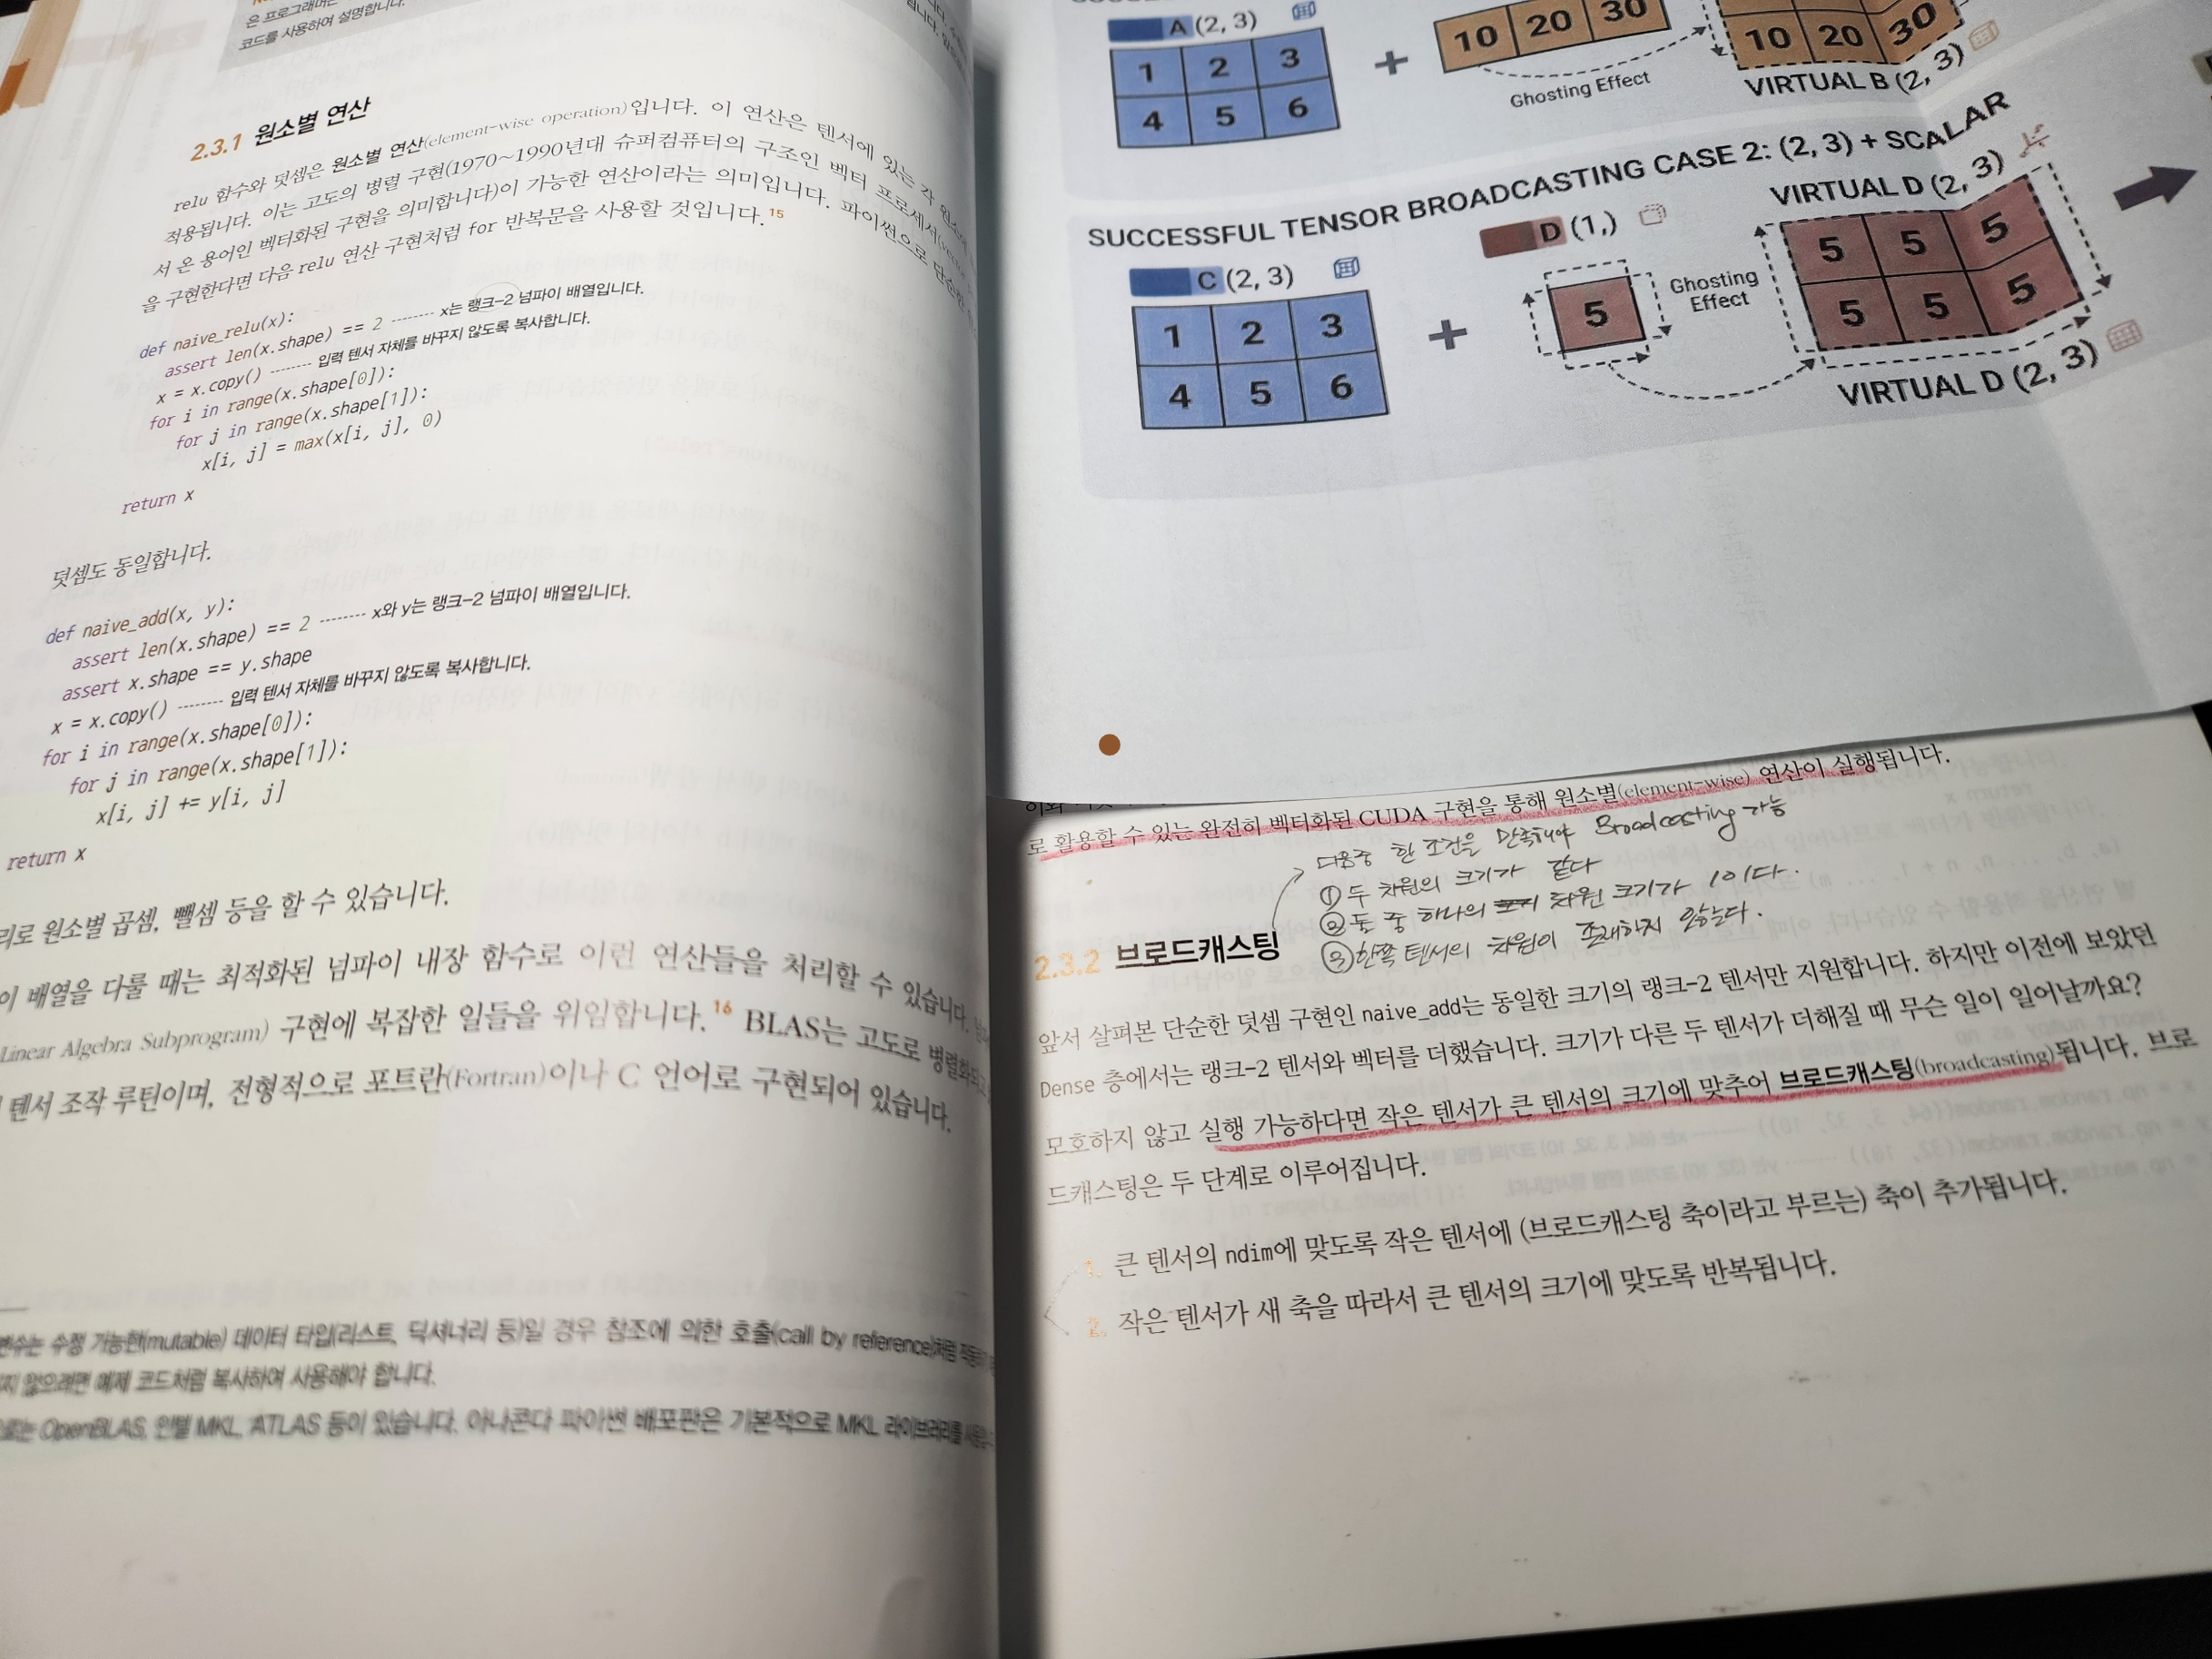
이번 3판을 보면서 1판을 함께 비교했는데, 내용이 겹치는 부분이 거의 없다. 숄레 말대로 완전히 새로 작성된, 이름만 같은 딥러닝 학습서이다. 특정 프레임워크에 갇히지 않고, 각 도구가 무엇을 추상화하고 노출하는지 구조적으로 보여주기 때문에 서비스 스택을 고민하는 개발자에게 폭넓은 안목을 제공하는 책이다.
여전히 진도는 더디게 나가고 술렁술렁 읽고 싶은 마음은 간절하지만, 그래도 곱씹어 가면서 차근차근 읽어나갈 생각이다. 아우~ 대체 2장과 4장을 몇번째 읽는건지 모르겠다. 점점 멍청해지는 나 자신이 느껴진다. 그나마 원서도 웹사이트로 제공되고 있어서, Ask Gemini 기능을 이용하여 잘 이해되지 않는 부분을 물어가면서 하나씩 격파해 나가고 있다.
책을 읽다가 지친 마음을 달랠 겸 19장 AI의 미래과 20장 결론 부분을 먼저 읽었다. "단순한 스케일업만으로는 진정한 지능(AGI)에 도달하기 어렵다"며 딥러닝의 명확한 한계와 일반화의 본질을 언급한다. 거품 가득한 마케팅 용어에 휘둘리지 않고 기술의 현주소를 냉철하게 바라보는 전문가의 묵직함이 느껴진다.
조금 더 읽어 나가다 보면 트랜스포머를 결국 만나게 될 것이다. 분발해서 끝까지 읽어보자. 이 책을 끝까지 읽고 나면 내가 만들고 싶었던 문제 도메인의 SLM 모델을 직접 학습시키면서 만들고, 이를 최적의 구조로 서비스할 수 있지 않을까(사이드 프로젝트로 진행하는 것이라 비용이 문제인데, 비용 최적화된 딥러닝 모델을 만들어 볼테다.)
나는 1장부터 7장, 19장~20장을 먼저 읽고, 8장부터는 사례 학습(이미지 분류, 구분, 감지, 시계열 예측, 텍스트 분류, 트랜스포머, 텍스트 생성, 이미지 생성) 순으로 읽어가는 중이다. 함께 읽어가고 있는 분들이 있다면 으쌰으쌰 같이 정리하면서 끝까지 완독해 보자!!!
같은 출판사에서 나온 <밑바닥부터 만들면서 배우는 LLM>과 한빛미디어의 <혼자 공부하는 딥러닝>책을 곁들이면 좋을 것 같다. 그러고보니 모든 책이 박해선님이 번역하신 책이네. 덕분에 잘 보고 있습니다~
뱀꼬리> 최근 여러 출판사에서 딥러닝 프레임워크, 특히 파이토치에 관한 책이 출간되고 있는데, 그 이유가 궁금합니다. 혹시 제 블로그를 찾아주시는 분들 중에 의견 달아주실 분 있으실까요? 한빛미디어에서도 <핸즈온머신러닝w/사이킷런,파이토치>가 나왔고, 더타이즈에서도 <멀티모달까지 직접구현하는 딥러닝 w/ 파이토치>도 나오고 해서요.
'0.잡담 > 0.1 책' 카테고리의 다른 글
| 와인버그에게 배우는 차곡차곡 글쓰기/인사이트 (0) | 2026.11.02 |
|---|---|
| 개발에 하네스를 적용한 경험을 공유하는 <AI루프를 설계하라> (0) | 2026.10.25 |
| 유쾌, 상쾌, 통쾌하면서 명랑한 AI 책-<생존을 위한 최소한의 AI 교양/조남호/골든래빗> (0) | 2026.09.27 |
| 벡터DB를 이해하면 RAG가 보인다 - 벡터데이터베이스/한빛미디어 (0) | 2026.09.27 |
| 21세기 언더독 하이닉스의 전기 (戰記, 傳記, 前記) - 슈퍼 모멘텀 (0) | 2026.09.04 |