평소 나는 SLM이 앞으로 두가지 측면에서 중요해질 것이라고 생각해 왔다.
첫째, AI가 동작해야 하는 환경에는 제약이 있다. 그것이 실시간성을 요구하는 기능적인 것일 수도 있고, 개인정보 보호같은 컴플라이언스 때문일 수도 있다. LLM의 성능이 우수하다고 하지만 산업현장이나 의료현장처럼 보안이나 규제가 존재하는 곳에서는 이야기가 달라진다. 제조업에 있는 지인도 SLM을 열심히 살펴보는 중인데, 장비의 센서 정보를 외부 서비스로 보낼 수도 없을 뿐더러, 요청을 보낸 뒤 언제 돌아올지 모르는 응답을 기다릴 수는 없다는 이야기를 들었다. 이런 환경에서는 모델의 절대적인 지능보다는 어디에서 실행할 수 있고, 얼마간의 자원으로 실행할 수 있고, 얼마나 도메인을 잘 이해하는가가 더 중요한 조건이 된다. Edge AI나 On-device AI가 계속 언급되는 이유이기도 하다.
둘째, 학습을 직접 경험하기 위한 현실적인 크기를 SLM은 제공해 준다. 우리가 다들 대형 언어모델을 이야기하지만, 개발자가 밑바닥부터 언어모델을 만들어 볼 일은 거의 없다. 실제 업무에서는 대부분 기존 모델을 선택하고, 데이터를 준비하여 파인튜닝하고, 평가하고, 양자화하거나 RAG를 붙여 원하는 성능을 만들어 가는 과정에 가까울 것이다.문제는 이 과정을 제대로 경험해 보려면 GPU 메모리와 학습 비용이라는 현실적인 부담이 존재하게 된다. 그래서 나는 SLM/sLLM이 단순히 작은 LLM을 넘어 학습 도구로 활용 가능성이 높다고 생각한다.
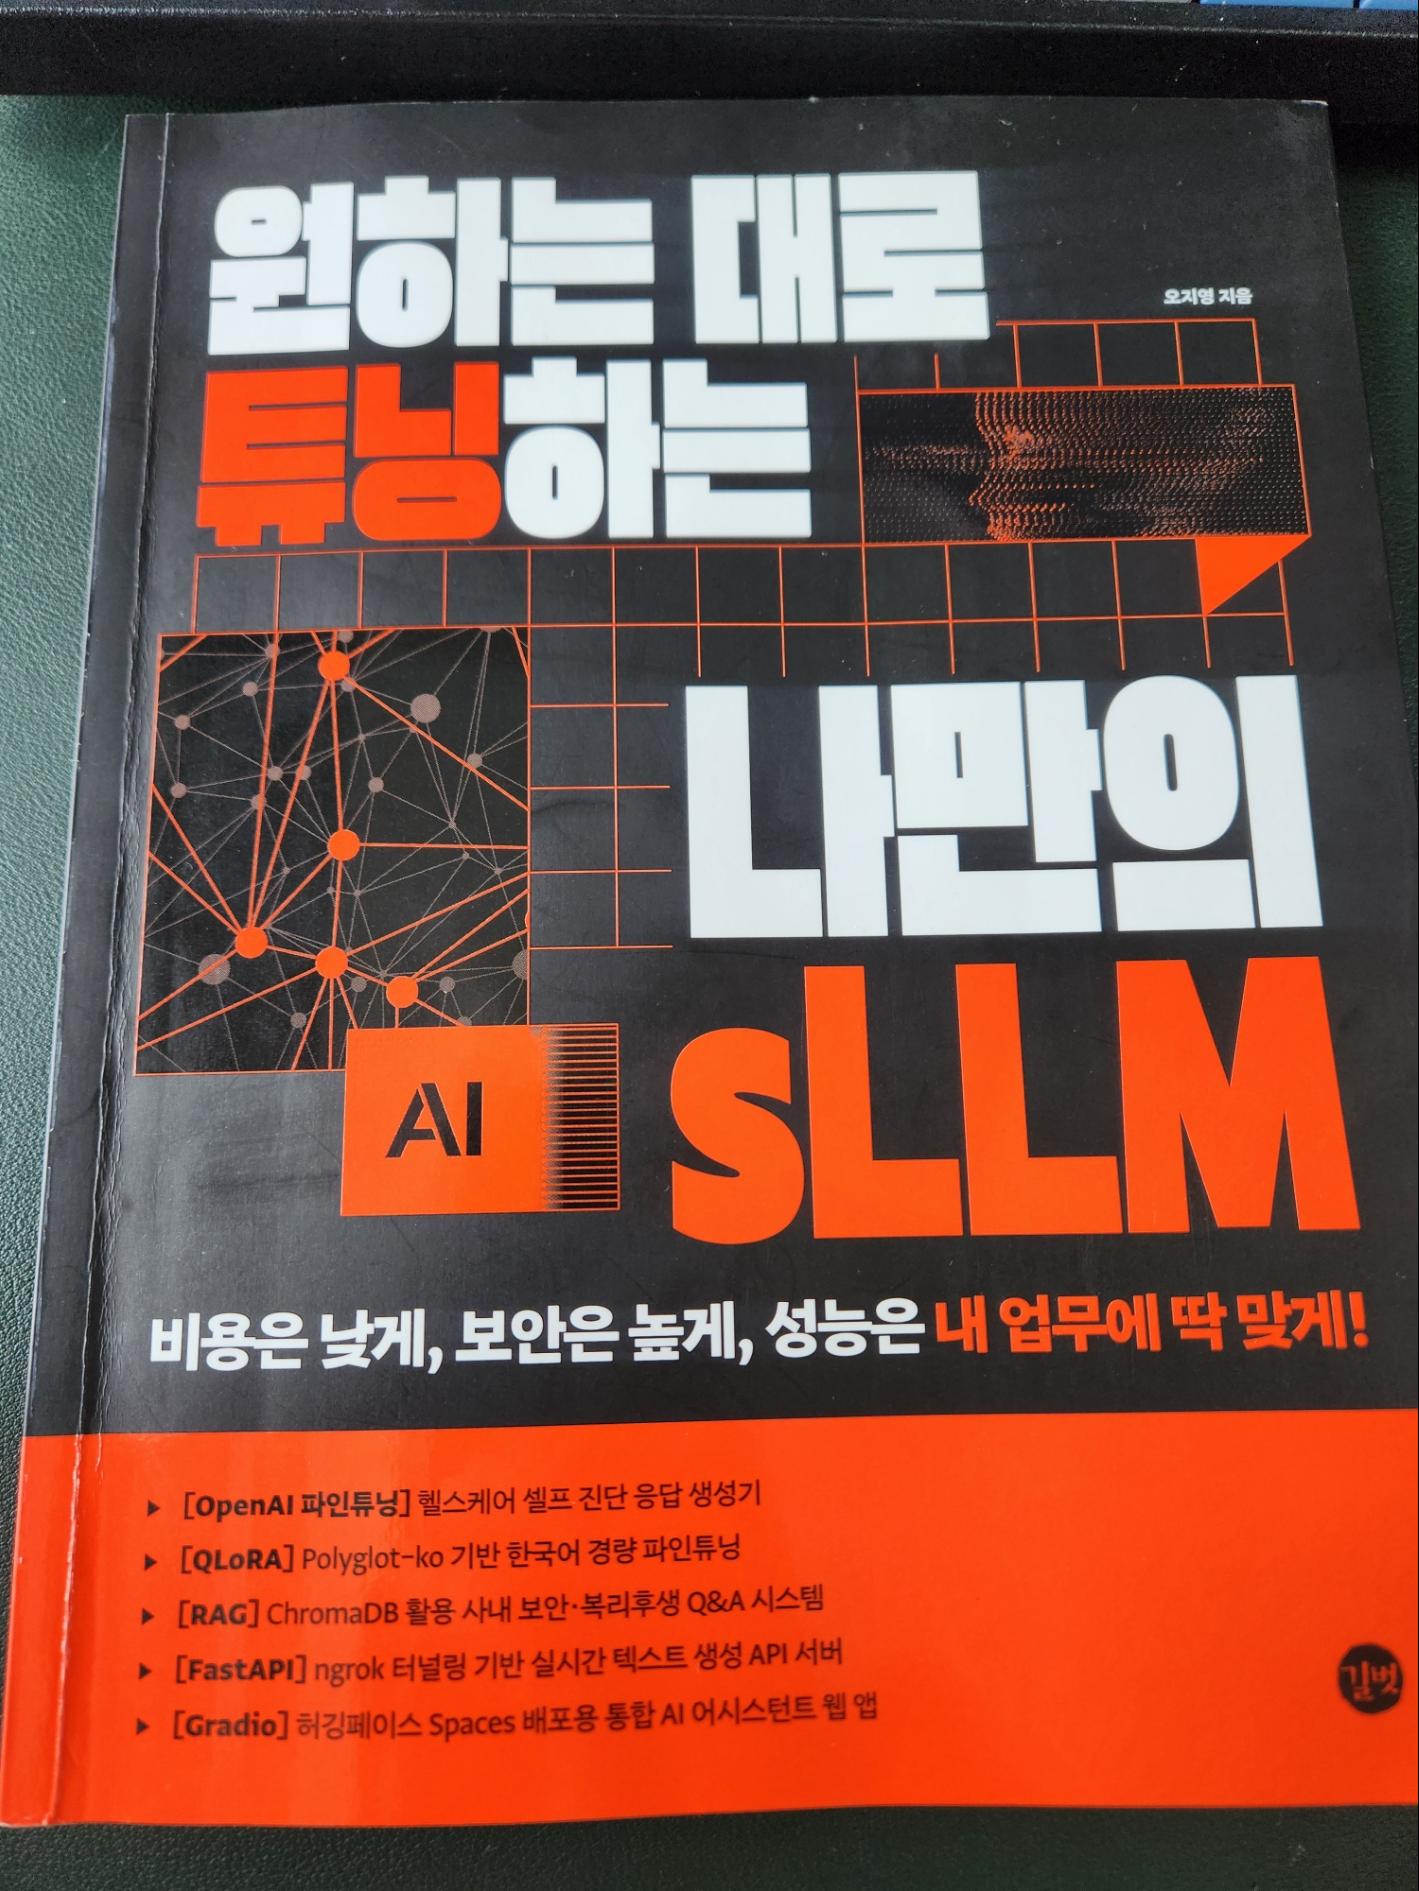
이런 고민을 하던 차에 길벗의 챗 <원하는대로 튜닝하는 나만의 sLLM>이 눈길을 끌 수밖에 없었다. 아차! 정확하게는 SLM이 아니라 sLLM이다. 이 책에서는 sLLM을 중점적으로 설명하는데, 중요한 것은 이름보다는 책이 다루는 범위다. 단순히 규모가 작은 모델을 소개하는데 그치지 않고 파인튜닝 방법부터 최적화, 서비스 구현까지 한 사이클을 모두 다룬다.
이 책에서 다루는 파인튜닝 과정을 제대로 로컬에서 실행해보려면 초기 투자비용이 발생한다. 물론 Google Colab에서도 실행할 수 있게 구성되어 있다.
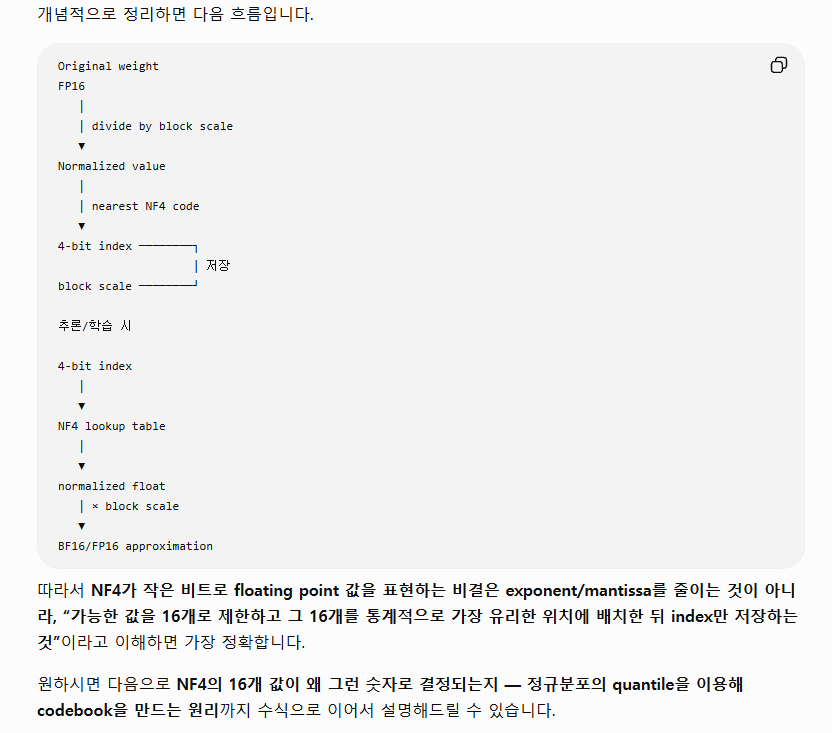
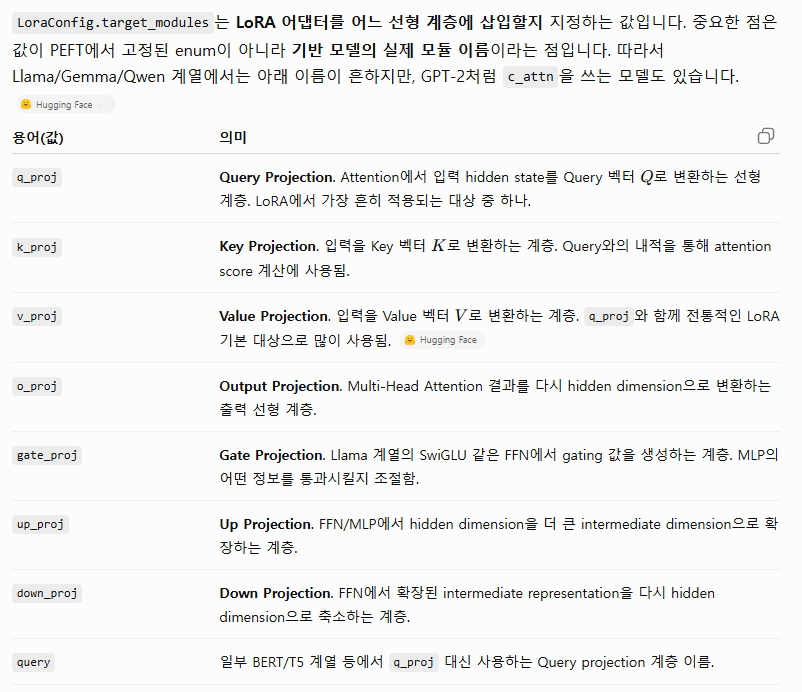
이 책에서 소개하는 개념들은 책 한권으로 이해하기는 만만치 않다. 책에 실린 코드에는 설명이 달려 있지만, 각 기술을 좀 더 파고들기 시작하면 그것만으로도 공부가 필요했다. 이 부족한 부분은 독자가 스스로 메워야하는 여백? 공간인데... 나는 그 간격을 GPT에게 계속 질문하면서 메워 나갔다.
개인적으로는 1장은 개발자가 아니더라도 AI에 관심 있는여러 사람들이 함께 읽어봤으면 좋겠다. 지금까지 나온 AI의 흐름과 관련 용어, 개념을 잘 정리해 두었다. 그냥 추세를 읽고 싶은 분들이라면 충분히 공감할 내용이 많다. 용어 정리도 잘 되어 있다. 1장은 업계 흐름의 큰 지도를 그린다.
2장과 3장은 고만고만했는데, 1장 기본 개념을 기반으로 sLLM으로 개념을 확장정리하였다. 개인적으로 1장만큼 강한 인상은 받지 못했다. 어느정도 AI 관련 내용을 계속 학습해 온 사람이라면 익숙한 내용들이었다. 처음 접한다면 굳이 왜 작은 모델인가에 대한 배경 지식을 잡을 수 있을 것 같다.
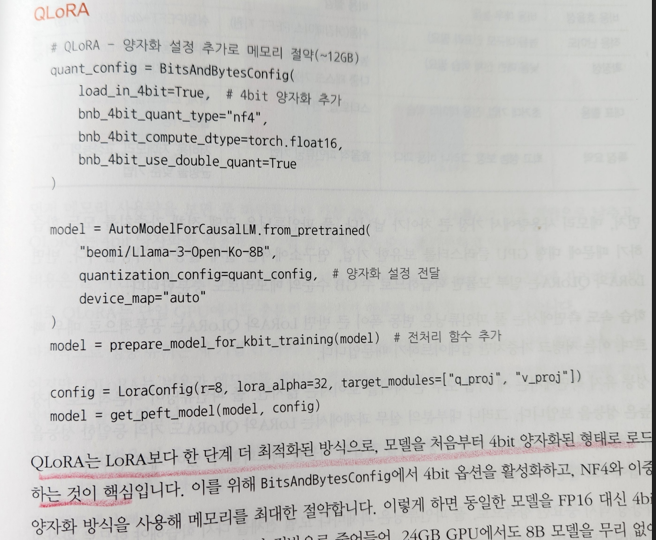
4장부터 7장까지가 실질적으로 모델을 학습시키면서 최적화하는 과정을 설명한다. 모델을 가져와 데이터를 준비한 후 파인튜닝을 하고, 모델을 압축하고, 추론비용을 줄이는 과정. 코드에 주석이 달려 있지만, 그렇다고 모든 코드의 내부 동작을 한 줄씩 설명해주는 스타일의 책은 아니다. 그래서 중간중간 멈춰서 따로 찾아보거나 GPT 선생님의 도움을 받아야 하는 부분이 꽤 있다. 반대로 말하지면 예를 따라가면서 전체과정을 한번 경험해 보는 것이 목표라면 적당한 것 같다.
8, 9장은 서비스로 구현하는 내용인데, 아직 읽고 있는 중이다.
SLM이나 sLLM을 이야기하다 보면 '잘 튜닝만 하면 작은 모델로도 LLM만큼 좋은 성능을 낼 수 있다'라는 주장도 자주 만나게 된다. 나는 최적화된 sLLM이나 SLM으로 범용적인 추론 능력과 광범위한 지식을 갖춘 LLM에 비할 성능을 얻을 수 있다는 말은 거짓이라 생각한다. 하지만 우리가 수행하는 반복적인 업무중 상당 부분은 LLM의 지능이 아니라 SLM/sLLM으로도 충분히 해결가능한 일이 많다. 이를 합리적으로 해결하는 것이 엔지니어의 몫이라 생각한다. 그래서 LLM으로 할 일과 SLM으로 할 일을 나눠 할당하는 것이 점점 더 중요할 것이라 본다.
이 책은 그 출발점으로 직접 자신의 컴퓨터 내지는 저가의 클라우드 환경에서 해보면서 배울 수 있는 내용을 담고 있는, 현 시점에서 볼 수 있는 몇 안되는 책이라 생각한다. 특정 파인튜닝 기술을 깊이 알고 싶다면 조금 부족한 느낌을 줄 수도 있겠다.
'0.잡담 > 0.1 책' 카테고리의 다른 글
| 21세기 언더독 하이닉스의 전기 (戰記, 傳記, 前記) - 슈퍼 모멘텀 (0) | 2026.09.04 |
|---|---|
| 사토시.....사토시...비트코인...블록체인... 여전히 잘 모르겠다. (0) | 2026.08.30 |
| 다시 소프트웨어 엔지니어가 주인공이 될 수 있을까? (0) | 2026.08.06 |
| 무엇을 할 것인가(GenAI)에서 어떻게 해낼 것인가(Physical AI)로 - 피지컬AI 시스템 설계/한빛미디어 (0) | 2026.07.28 |
| 미소 지으며 걷는 삶에 대하여 - 권순표님의 <오늘은 괜찮은 하루> (0) | 2026.07.25 |