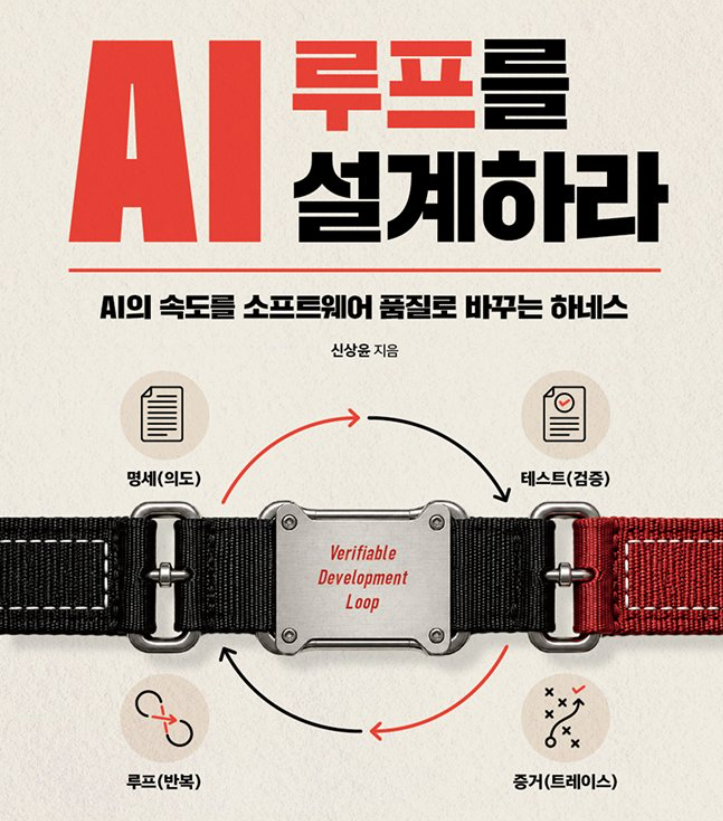
책은 다른 사람의 사고나 경험을 간접 체험할 수 있는 매우 저렴한 수단이다. AI에 대한 감각을 계속 갱신하기 위해 여러 가지 책을 읽어보는 중이다. 하지만 여전히 눈에 거슬리는 몇몇 단어들이 전면에 있는 책 표지는 불편하다. 나에게는 하네스와 AI 루프, ○ ○ ○ 엔지니어링이 그러하다. 이 책은 그중 두 개를 제목에 내세웠다. 하네스, AI 루프.
처음에는 그냥 트렌드 추적용으로 생각하고 별 기대없이 책을 펼쳤는데, 다른 책들에서는 접하기 어려운 저자 자신만의 소프트웨어 개발 하네스와 루프에 대한 경험과 생각이 잘 정리되어 있어서 좋았다. 대부분의 책이 루프는 이런 것이야, 하네스는 이런 것이야에 머물러 있다면 현업에서 적극적으로 도입해 보면서 실제로 겪은 일을 기반으로 생각을 정리했다는 점에서 이 책은 가치가 있다고 생각한다. 저자의 생각에 100%까지는 동의하지 못하지만, 고민의 방향은 100% 동의한다. 저자분은 게임 개발을 근 20년 가까이하신 개발자. 나의 생각과 같든 다르든, 자신의 경험을 용기 있게(?) 공개하고 의견을 나누는 책들이 많이 출간되면 좋겠다.
이 책은 켄트백이었나 엉클밥이었나, 여튼 두 사람 중 한 명이 소개했던 Cucumber를 살펴보면서 스쳐지나갔던 Gherkin을 소개한다. 잘 사용하시는 분인 것 같다. 사고의 프레임워크로도 괜찮아 보이는데, 다시 한번 신규 서비스 개발 과정에 적극적으로 시도해 봐야겠다. As.... I want to... So that.....처럼 Given... When.. Then..으로 요구사항을 검토하는 것도 왠지 전체적인 명세를 명확히 만들어가는데 도움이 될 것 같다.
책 읽으면서 밑줄친 부분...
- 우리의 의도가 AI라는 컴파일러를 거쳐 기계가 실행할 수 있는 형태로 바꾸니 산출물에 가깝다.... 무엇을 만들 것인가에 대한 인간의 명확한 의도인 명세(Spec)와, 그 의도를 논리적으로 구조화한 설계(Design)가 본체이다.... 코드는 원본은 아니지만, 여전히 우리가 책임져야 할 결과물이다... 원본을 쥐고 있는 자가 시스템을 통제한다... 개발의 중심은 문법(syntax)에서 의도(Intent)로 이동했다.
- 설계하려는 기능의 동작 의도를 Context, Trigger, Reaction으로 나누어 구조화된 명세에 담아야 한다.... 우리가 무심코 생략한 빈칸은 소프트웨어 결함의 서식지이자 AI의 추정이 시작되는 자리이다.... 빈칸은 엔지니어 먼저 채워야 한다. 그래야 AI도 우리가 정한 경계 안에서 코드를 만든다... AI는 인간이 정한 WHAT을 바탕으로 HOW의 실행(execution)을 맡는다.
- Gherkin: Given/When/Then의 3단 구조는 기능의 동작을 조건, 행위, 결과로 나누어 작성하게 한다... 자연어 명세를 Gherkin 시나리오로 바꾸는 변환과정에서 작성자 스스로도 미처 인지하지 못했던 논리의 구멍을 발견할 수 있기 때문,.
- 엔지니어의 실력은 AI가 추론해야 할 작업과 기계적으로 검증해야 할 작업을 명확히 분리하여 루프를 배치하는데에서 드러난다... 엔지니어는 흩어진 단서를 연결해 문제를 정의하는 지능이었고, 이슈 시스템과 터미널, IDE사이에서 데이터를 옮기는 하네스였으며, 가설을 세우고 검증을 반복하는 루프 그 자체였다... 흔적을 남기지 않는 루프는 같은 실수를 반복한다.
- 하나의 태스크가 끝나면 세 종류의 기억이 남는다. 제품 코드가 어떤 경로로 실행되었는지, 에이전트가 어떤 과정을 거쳐 작업했는지, 다음 태스크가 무엇을 믿고 이어갈지를 각각 기록한다.
- AI는 전달받은 코드와 문맥 안에서 논리적으로 타당한 결과를 만들었을 뿐이다. 문제는 제품의 역사적 배경과 암묵적인 비즈니스 규칙을 전송하지 않은 채 결과를 운영에 반영한 데 있다.... 아무리 부조리해 보이는 코드라도 운영 환경에서 실제로 어떻게 동작하는지 증거를 확보하기 전까지는 손대지 않아야 한다.
- Mock을 많이 만든다고 해서 테스트하기 쉬운 구조가 되는 것은 아니다. 중요한 것은 외부 시스템과의 경계를 얼마나 작고 명확하게 통제하느냐다.... 절개선은 코드를 예쁘게 다듬기 위한 추상화가 아니다. 기존 동작을 검증하기 위해 테스트가 개입할 최소한의 통로이다.
- 사람의 기억 속에 잠들어 있는 비즈니스 규칙을 기계가 넘지 못할 가드레일로 바꾸려면 누구나 읽을 수 있는 명확한 문장으로 선언해야 한다.
'0.잡담 > 0.1 책' 카테고리의 다른 글
| 와인버그에게 배우는 차곡차곡 글쓰기/인사이트 (0) | 2026.11.02 |
|---|---|
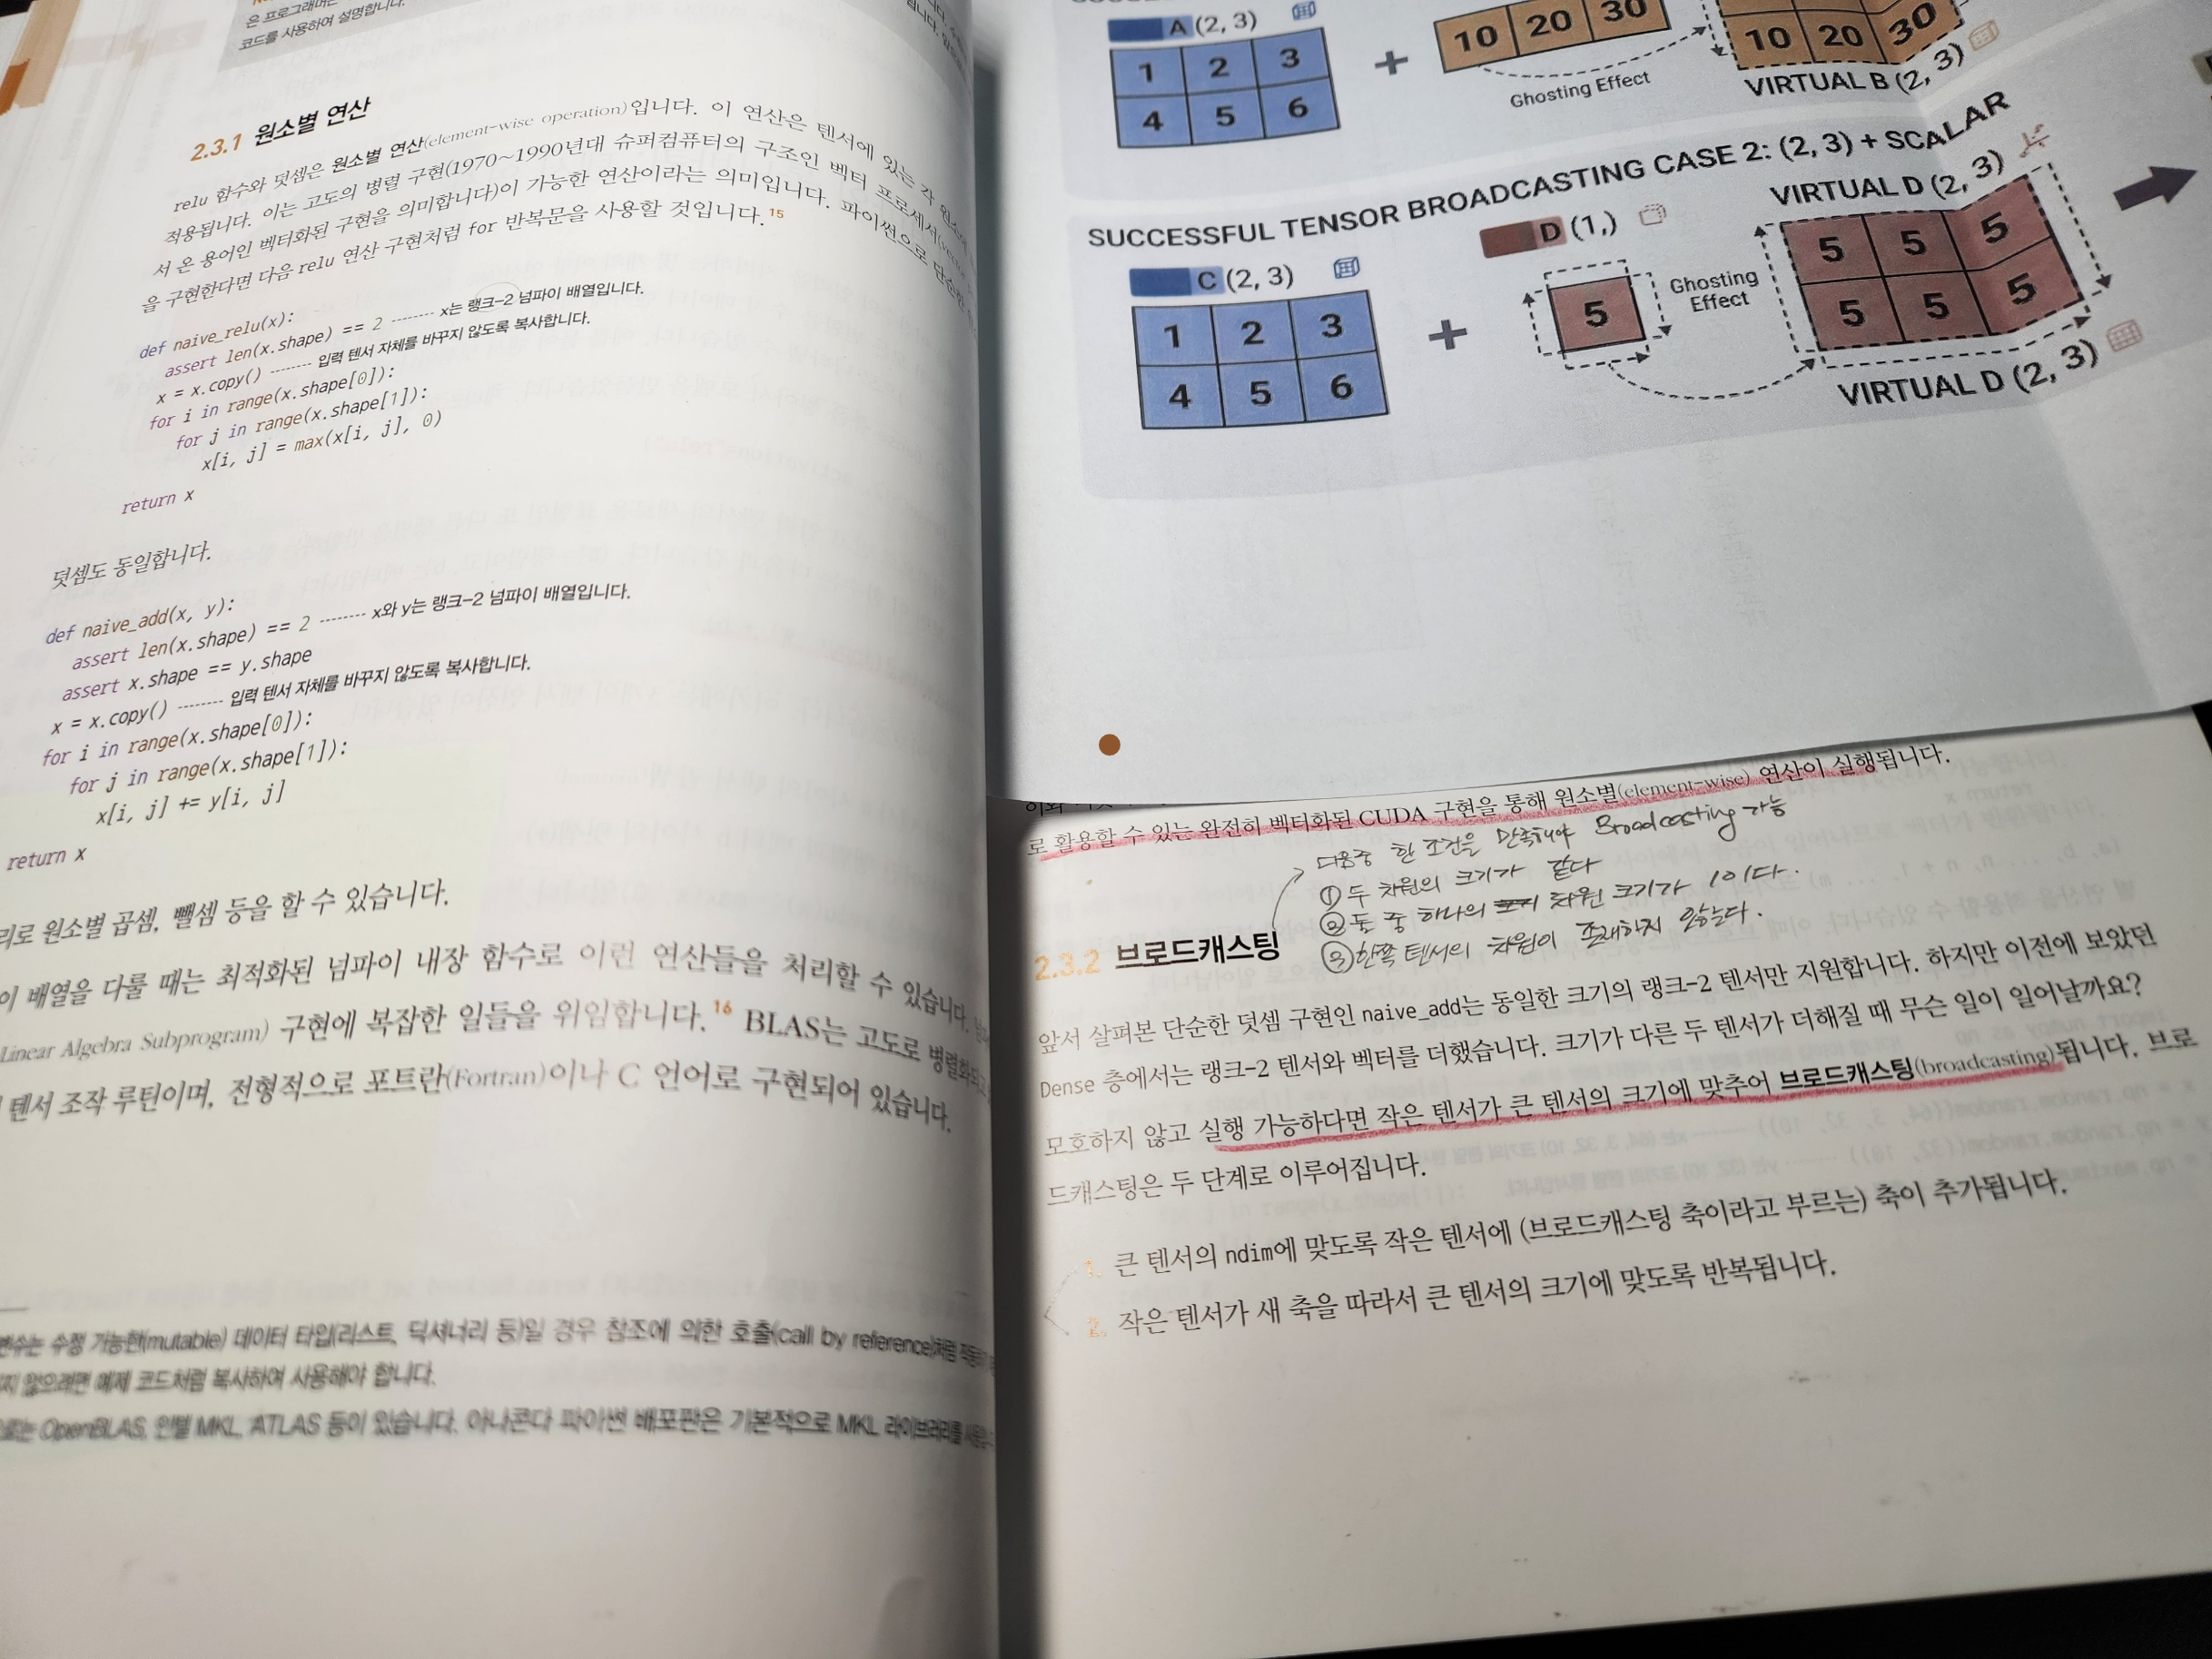
| 케라스 창시자인 프랑소와 숄레에게 배우는 딥러닝+파이썬/길벗 (0) | 2026.10.18 |
| 유쾌, 상쾌, 통쾌하면서 명랑한 AI 책-<생존을 위한 최소한의 AI 교양/조남호/골든래빗> (0) | 2026.09.27 |
| 벡터DB를 이해하면 RAG가 보인다 - 벡터데이터베이스/한빛미디어 (0) | 2026.09.27 |
| 21세기 언더독 하이닉스의 전기 (戰記, 傳記, 前記) - 슈퍼 모멘텀 (0) | 2026.09.04 |