한빛미디어 서평단 <나는리뷰어다> 활동을 위해서 책을 협찬받아 작성된 서평입니다.
어느새 RAG는 손쉽게 구현할 수 있는 것처럼 여겨지지만, 기반 지식없이는 효율적으로 원하는 바를 구현하기가 쉽지 않다고 생각한다. 물론 RAG를 보다 쉽고 효과적으로 구축할 수 있는 다양한 오픈소스 프레임워크들이 나오고 있지만, 그래도 기반 동작을 익히는 데에는 이유가 있다. 이번에 읽은 책 <벡터 데이터베이스(한빛미디어, 니틴 보르완카르 저) >는 RAG의 핵심 구성요소인 임베딩과 벡터DB의 기본을 다져주는 책이다.
한빛에서 번역서가 나오기 전에 원서로 앞부분을 읽었던 터라, 2장 임베딩과, 5장 PGVector 이용한 논문 검색 시스템 구축, 6장 Ollama로 RAG 시스템 구축하기 관련 내용을 중점적으로 읽었다. 역시 한글이 쏙쏙 쉽고 빠르게 읽힌다.
먼저 임베딩부터 이야기해보자면, 문장을 구성하는 토큰을 다차원 공간에 매핑함으로써 유사한 어휘(토큰)들이 비슷한 공간에 위치하게 만드는 것이다. 좀 더 정확히 기술하자면 비정형 데이터를 고차원 벡터 공간의 숫자 표현으로 변환하는 것이다. 의미나 맥락이 비슷한 데이터는 이 벡터 공간에서도 상대적으로 가까운 위치에 배치된다. 가장 유명한 그림이 아래 그림이다. Word2Vec이 보여준 흥미로운 결과중 하나가 단어 사이의 의미 관계를 벡터 연산으로 어느정도 드러난다는 점이다. 인간이 사용하는 언어의 관계가 군집으로 표현되고, 그 군집간 벡터를 상징하는 단어가 있다는 사실이 놀랍다. 이걸 처음 발견한 초기 연구자들은 어떤 감정이었을까?
예전에 검색엔진 개발 팀에서 형태소 분석 결과를 바탕으로 역색인 파일을 만들고, 동의어 검색을 구현하기 위해 사전을 만들고, 사용자 질의를 어떻게 확장할 것인지를 정의하기 위해 온갖 짓들을 다했는데, 그때와 비교하면 요즘 임베딩과 벡터DB로 구현된 시맨틱 검색은 정말 엄청난 상전벽해의 느낌을 준다.
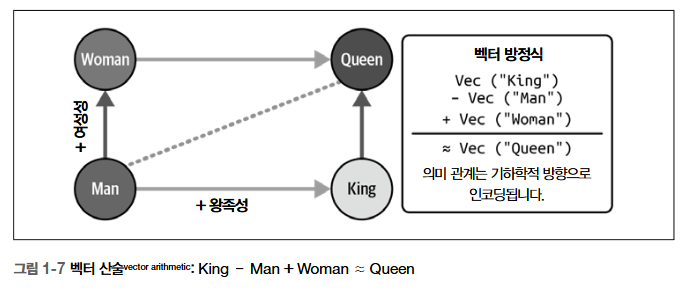
이 관계를 Word2Vec, Doc2Vec, 트랜스포머 모델까지 설명하면서 벡터데이터베이스의 등장 배경을 설명하는 것이 1장과 2장의 주요 내용이다. RDB나 NoSQL로도 벡터를 저장할 수 있지만, 코사인 유사도나 최근접 이웃검색을 효과적으로 수행하기엔 역부족이다. 그래서 결국 HNSW나 ANN 인덱스 등으로 벡터 검색에 특화된 벡터DB 사용을 고려할 수 밖에 없다. 개인적으로는 별도의 벡터DB를 도입하기 전에 일단 pgvector를 검토한다. FAISS, SQLite3-VSS,Chroma 등이 있지만, 메타 데이터와 벡터를 하나의 트랜잭션 경계 내에서 관리한다는 장점도 크고, 별도의 운영 시스템을 추가하기 않아도 되므로 pgvector를 사용하는 것이 정답이라 생각한다.
책의 전체적인 얼개는 벡터DB의 필요성 -> 개인이 사용하는 RAG 유틸 -> 서비스로 구축하기 -> 앞으로의 개선점(벡터 질의 언어)로 구성된다. 1,2장은 벡터DB의 등장 배경, 필요성을 언급했다면 3장에서는 벡터DB의 유사도 검색을 위한 색인(인덱싱) 기법을 설명한다. 정확도를 약간 희생하더라도 검색속도를 높이기 위한 인덱싱 기법을 살펴보면 벡터DB가 단순히 벡터 데이터를 저장하는 것이 아니라는 점을 알 수 있다. 5장에서는 arXiv 논문을 다운로드 받아서 텍스트를 추출하고, 이를 청크로 나눠서 벡터화한 다음, 조회하는 시스템을 Pgvector를 기반으로 구현한다. 6장은 Sqlite3를 사용하지만 Ollama를 통한 로컬 임베딩 API를 사용하는 것에 대한 내용이 주다. 임베딩 모델은 대체로 크기가 작은 편이므로 충분히 로컬 검색 환경을 구성하기가 쉽다. 이후 장에서 다루는 내용은 개인이 사용하는 것이 아니라 서비스로 구축하기 위한 스키마 설계부터 데이터 처리 파이프라인을 다룬다.
따라서 RAG를 한번이상 고민해 봤다면 1장부터 3장까지는 상식 측면에서 쉽게 읽을 수 있고, 4장부터는 서비스를 구축하는 과정으로 이해해서 8장까지 파이썬 코드와 함께 책을 읽으면 된다. 전체적으로 벡터DB와 RAG에 대하여 좀 더 자세히 이해하는데 도움이 되는 책이다. 다시 한번 RAG에서 어려운 부분은 벡터 검색 구현이 아니라, 어떤 데이터를 수집하여 청크를 어떻게 나누고, 어떻게 임베딩하며, 메타 데이터를 관리할 것이며, 검색 결과를 평가하는 것이 더 중요하다는 점을 느낀다. 결국 RAG도 데이터 엔지니어링의 도메인에 속하는 것 같다.
파이썬 코드를 사용하지만, 그렇게 난이도가 있는 코드를 사용하지 않으므로(또한 파이썬도 직관적인 언어이므로) 개발자 뿐만 아니라 AI 서비스 기획자도 앞부분부터 차례대로 읽어나가면서 개념을 이해할 수 있는 책이라 생각된다. RAG 시스템을 구축하겠다 이런 의도를 가진 팀이라면 반드시 학습해야 장점과 단점, 한계점을 공유할 수 있을 것이다.
단점은..결국 원서인 까닭에 한글 처리에 대한 내용이 부족하다. 책에서는 all-MiniLM-L6-v2 모델을 주로 사용하는데, 이 모델은 한국어 처리가 부실한 것으로 알려져 있다. 따라서 다중언어 버전인 paraphrase-multilingual-MiniLM-L12-v2이나 한국어에 특화된 KURE모델, Ko-SBERT 모델 등으로 예제가 보완되었으면 어떨까 하는 아쉬움이 있다. LLM이 등장하면서 한국어 처리의 벽이 많이 무너지긴 했지만, 그래도 벽은 여전히 벽이다.
9월 벡터DB와 함께 떠난 여행은 재미있었다.
'0.잡담 > 0.1 책' 카테고리의 다른 글
| 케라스 창시자인 프랑소와 숄레에게 배우는 딥러닝+파이썬/길벗 (0) | 2026.10.18 |
|---|---|
| 유쾌, 상쾌, 통쾌하면서 명랑한 AI 책-<생존을 위한 최소한의 AI 교양/조남호/골든래빗> (0) | 2026.09.27 |
| 21세기 언더독 하이닉스의 전기 (戰記, 傳記, 前記) - 슈퍼 모멘텀 (0) | 2026.09.04 |
| 사토시.....사토시...비트코인...블록체인... 여전히 잘 모르겠다. (0) | 2026.08.30 |
| 모든 일에 LLM이 필요한 것은 아니다. -작은 모델로도 충분할 지도.. (0) | 2026.08.28 |